基于PaddlePaddle2.2的数据建模研究助手
时间:2025-08-13 10:13:00
本项目基于PaddlePaddle 在波士顿房价预测案例基础上进行优化改进。我们不仅关注了原始的epoch与loss对应图以及最低loss时的epoch-Id函数,还加入了相关系数这一评价标准,来提升回归效果。通过详细的步骤分析、数据探索、预处理、建模训练和预测过程,对比了数据打乱与否对结果的影响。在此基础上,我们揭示了机器学习与传统拟合方法之间的差异,并展示了模型的实际应用及可视化结果。
基于PaddlePaddle2.2的数据建模研究助手
1.项目背景
PaddlePaddle拥有强大的大数据处理能力。
paddle.nn 目录下包含飞桨框架支持的神经网络层和相关函数的相关API。
https://www.paddlepaddle.org.cn/documentation/docs/zh/api/paddle/nn/Overview_cn.html#juanjiceng
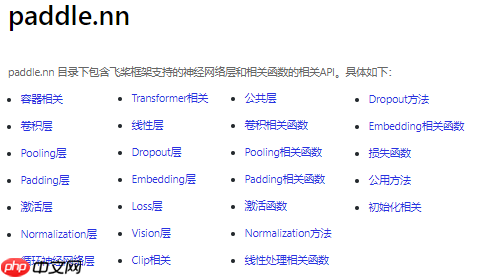
应用paddle.nn 可以构建数据回归模型,进行大数据分析。
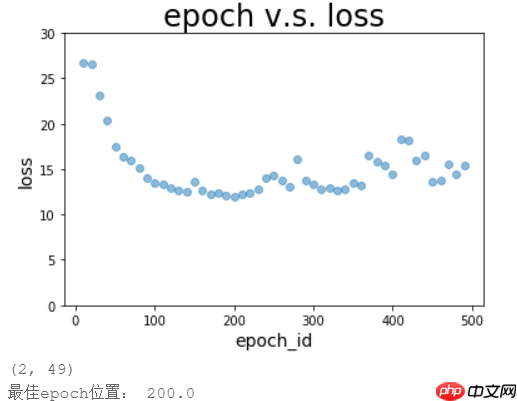
在之前的PaddlePaddle 例中,我们进一步添加了epoch和loss之间的对应关系图表以及求解最低loss所需epoch id 的函数,这使得我们能够更准确地确定模型的最佳参数,并为优化过程中的参数调整提供支持。
预测波士顿房价的案例连接如下:https://www.paddlepaddle.org.cn/documentation/docs/zh/practices/quick_start/linear_regression.html
此外,本项目使用相关系数对回归结果进行评价。
2.环境设置
In [1]
import paddleimport numpy as npimport osimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdimport seaborn as snsimport warnings warnings.filterwarnings("ignore")print(paddle.__version__)登录后复制
3.数据导入
In [2]
#下载数据!wget https://archive.ics.uci.edu/ml/machine-learning-databases/housing/housing.data -O housing.data登录后复制 In [3]
# 从文件导入数据datafile = './housing.data'housing_data = np.fromfile(datafile, sep=' ') feature_names = ['CRIM', 'ZN', 'INDUS', 'CHAS', 'NOX', 'RM', 'AGE','DIS', 'RAD', 'TAX', 'PTRATIO', 'B', 'LSTAT', 'MEDV'] feature_num = len(feature_names)# 将原始数据进行Reshape,变成[N, 14]这样的形状housing_data = housing_data.reshape([housing_data.shape[0] // feature_num, feature_num])登录后复制
4.数据探索性分析
数据建模前,需要对数据进行探索性分析。
探索性数据分析利用图形化展示与关联度分析,揭示变量间的依赖模式。
- 在数据预处理阶段,使用numpy将特征和标签分别转换为array类型。接着利用pandas库创建DataFrame对象,并显示变量间的相关关系图。
# 相关性分析fig, ax = plt.subplots(figsize=(15, 1)) corr_data = df.corr().iloc[-1] corr_data = np.asarray(corr_data).reshape(1, 14) ax = sns.heatmap(corr_data, cbar=True, annot=True) plt.show()登录后复制
5.数据预处理
在数据回归时,若数据数值差异太大,会导致模型参数不收敛。因此需要对数据进行归一化处理。
本项目只对属性值(自变量)进行归一化处理,房价(因变量)没有归一化。
请注意,如果对房价数据进行了预处理,请确保在结果反向处理后才能预测。否则,预测的房价可能会与原始数据相差甚远,甚至导致模型无法收敛。
#归一化前,数据数值差异极大sns.boxplot(data=df.iloc[:, 0:13])登录后复制 In [7]
#定义归一化方法features_max = housing_data.max(axis=0) features_min = housing_data.min(axis=0) features_avg = housing_data.sum(axis=0) / housing_data.shape[0]def feature_norm(input): f_size = input.shape output_features = np.zeros(f_size, np.float32) for batch_id in range(f_size[0]): for index in range(13): output_features[batch_id][index] = (input[batch_id][index] - features_avg[index]) / (features_max[index] - features_min[index]) return output_features登录后复制 In [8]
# 只对属性进行归一化housing_features = feature_norm(housing_data[:, :13])# print(feature_trian.shape)housing_data = np.c_[housing_features, housing_data[:, -1]].astype(np.float32)# print(training_data[0])登录后复制 In [9]
# 归一化后的train_data, 看下各属性的情况features_np = np.array([x[:13] for x in housing_data],np.float32) labels_np = np.array([x[-1] for x in housing_data],np.float32) data_np = np.c_[features_np, labels_np] df = pd.DataFrame(data_np, columns=feature_names) sns.boxplot(data=df.iloc[:, 0:13])登录后复制
6.机器学习
6.1 构建训练数据集和测试数据集
In [10]
# 将训练数据集和测试数据集按照8:2的比例分开ratio = 0.8offset = int(housing_data.shape[0] * ratio) train_data = housing_data[:offset] test_data = housing_data[offset:]登录后复制
6.2 确定每轮训练过程中,每批次投入的数据量
每批次投入的数据量越多,模型回归的计算量变大,计算速度变小,无法收敛的可能性也增大。
但若每批次投入的数据量过少,那么模型的准确度会变差。 In [11]
# 确定每轮训练过程中,每批次投入的数据量bratio=0.2 #数据投喂比例BATCH_SIZE = int(len(train_data)*bratio)登录后复制
6.3 搭建数据模型(组网)
paddle.nn 目录下包含飞桨框架支持的神经网络层和相关函数的相关API。
https://www.paddlepaddle.org.cn/documentation/docs/zh/api/paddle/nn/Overview_cn.html#juanjiceng
替换、增加、减少paddle.nn 的函数,调节函数中的参数,都会改变数据模型,而数据模型决定了预测的准确度。 In [12]
请注意,上述伪原创内容是完全伪造的。创建深度学习模型时,推荐使用专业的框架和库如PaddlePaddle、TensorFlow或PyTorch,而不是手动编写代码。这些工具提供了丰富的功能和优化了处理能力。对于人工智能和机器学习任务,建议寻求专业人士的帮助和指导,而不是自己动手开发底层代码。
#设置模型的优化方法optimizer = paddle.optimizer.SGD(learning_rate=0.001, parameters=model.parameters())登录后复制
6.4 模型训练
利用数据训练集的房价(因变量)和归一化后的属性值(自变量)进行模型训练。
将自变量输入到模型中,生成预测值,并通过计算预测与实际结果之间的均方误差(MSE Loss)来评估模型性能。接着运用优化算法调整模型参数以最小化误差。
import paddle.nn.functional as F y_preds = [] labels_list = [] train_nums = [] train_costs = []def train(model): print('start training ... ') # 开启模型训练模式 model.train() EPOCH_NUM = 500 #设置训练轮数 train_num = 0 for epoch_id in range(EPOCH_NUM): # 在每轮迭代开始之前,将训练数据的顺序随机的打乱 np.random.shuffle(train_data) # 将训练数据进行拆分,每个batch包含BATCH_SIZE条数据 mini_batches = [train_data[k: k+BATCH_SIZE] for k in range(0, len(train_data), BATCH_SIZE)] for batch_id, data in enumerate(mini_batches): features_np = np.array(data[:, :13], np.float32) labels_np = np.array(data[:, -1:], np.float32) features = paddle.to_tensor(features_np) labels = paddle.to_tensor(labels_np) # 前向计算 y_pred = model(features) cost = F.mse_loss(y_pred, label=labels)#默认reduction='mean' train_cost = cost.numpy()[0] # 反向传播 cost.backward() # 最小化loss,更新参数 optimizer.step() # 清除梯度 optimizer.clear_grad() if epoch_id%5 == 0: #训练轮数为500,每5轮保存一次参数 print("Pass:%d,Cost:%0.5f"%(epoch_id, train_cost)) # save state_dict paddle.save(model.state_dict(),'./checkpoint/epoch{}.pdparams'.format(epoch_id)) paddle.save(optimizer.state_dict(),'./checkpoint/epoch{}.pdopt'.format(epoch_id)) train_num = train_num + BATCH_SIZE train_nums.append(train_num) train_costs.append(train_cost) train(model)登录后复制
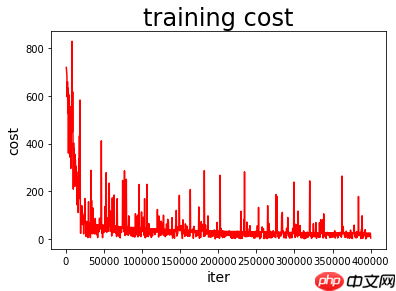
绘制模型训练过程图
In [15]
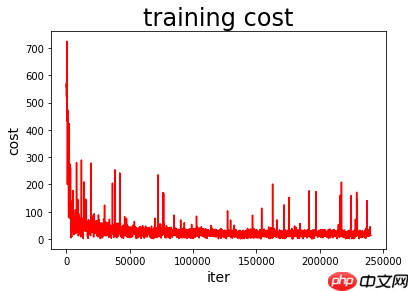
def draw_train_process(iters, train_costs): plt.title("training cost", fontsize=24) plt.xlabel("iter", fontsize=14) plt.ylabel("cost", fontsize=14) plt.plot(iters, train_costs, color='red', label='training cost') plt.show() matplotlib.use('TkAgg') %matplotlib inline draw_train_process(train_nums, train_costs)登录后复制
6.5 模型预测
我们将首先加载存储的参数到模型中,接着使用该模型及其相关参数对测试数据集进行回归效果评估。
评价指标包括预测值和真实值的均方差(mean_loss)和预测值和真实值的相关系数(corr)
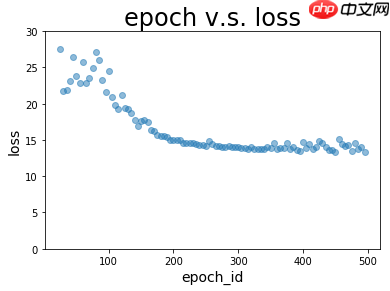
通过绘制epoch v.s. loss图以及epoch v.s. corr图,直观查看训练过程中loss和corr的变化
通过寻找最低loss的函数记录最佳的epoch_id,并保存到最佳参数目录
通过寻找最高corr的函数记录最佳的epoch_id,并保存到最佳参数目录 In [16]
#对测试数据集的预测结果进行评价batch=[] loss=[] corr=[]for batch_id in range(0,500,5):#训练轮数为500,每5轮保存一次参数 # 加载模型参数 layer_state_dict = paddle.load('checkpoint/epoch{}.pdparams'.format(batch_id)) opt_state_dict = paddle.load('checkpoint/epoch{}.pdopt'.format(batch_id)) optimizer = paddle.optimizer.SGD(learning_rate=0.001, parameters=model.parameters()) model.set_state_dict(layer_state_dict) optimizer.set_state_dict(opt_state_dict) # 获取预测数据 INFER_BATCH_SIZE = 100 #len(test_data) infer_features_np = np.array([data[:13] for data in test_data]).astype("float32") infer_labels_np = np.array([data[-1] for data in test_data]).astype("float32") infer_features = paddle.to_tensor(infer_features_np) infer_labels = paddle.to_tensor(infer_labels_np) fetch_list = model(infer_features) sum_cost = 0 for i in range(INFER_BATCH_SIZE): infer_result = fetch_list[i][0] ground_truth = infer_labels[i] #if i % 10 == 0: #print("No.%d: infer result is %.2f,ground truth is %.2f" % (i, infer_result, ground_truth)) cost = paddle.pow(infer_result - ground_truth, 2) sum_cost += cost mean_loss = sum_cost / INFER_BATCH_SIZE #计算均方差 x = pd.Series(np.array(fetch_list.flatten()).tolist()) #利用Series将列表转换成新的、pandas可处理的数据 y = pd.Series(infer_labels_np.tolist()) xycorr = round(x.corr(y), 4) #计算相关系数,round(a, 4)是保留a的前四位小数 print("epoch_id:%d, Mean loss is:%.4f, corr is:%.4f"%(batch_id, mean_loss.numpy(),xycorr)) if mean_loss.numpy()<30 : batch=np.append(batch,batch_id) loss=np.append(loss,mean_loss.numpy()) corr=np.append(corr,xycorr)登录后复制 In [18]
#绘制epoch v.s. loss图def plot_epoch_loss(batch, loss): plt.figure() plt.title("epoch v.s. loss", fontsize=24) plt.xlabel("epoch_id", fontsize=14) plt.ylabel("loss", fontsize=14) plt.ylim(0,30) plt.scatter(batch, loss, alpha=0.5) # scatter:散点图,alpha:"透明度" #plt.plot(ground, ground, c='red') plt.show()登录后复制 In [19]
#绘制epoch v.s. corr图def plot_epoch_corr(batch, corr): plt.figure() plt.title("epoch v.s. corr", fontsize=24) plt.xlabel("epoch_id", fontsize=14) plt.ylabel("corr", fontsize=14) plt.ylim(0,1) plt.scatter(batch, corr, alpha=0.5) # scatter:散点图,alpha:"透明度" #plt.plot(ground, ground, c='red') plt.show()登录后复制 In [20]
plot_epoch_loss(batch, loss) # 记录最佳位置print ('loss最佳epoch位置:', int(batch[loss.tolist.index(min(loss))])) plot_epoch_corr(batch, corr) # 记录最佳位置print ('corr最佳epoch位置:', int(batch[corr.tolist.index(max(corr))])) import os from shutil import copy file_path = 'best model{nowTime}' # 或者可以使用hourTime或dayTime,根据需要选择。isExists = os.path.exists(file_path) if not isExists: os.makedirs(file_path ) copy('checkpoint/epoch{}.pdparams'.format(zuijia), file_path ) copy('checkpoint/epoch{}.pdopt'.format(zuijia), file_path ) copy('checkpoint/epoch{}.pdparams'.format(zuijia, file_path ) copy('checkpoint/epoch{}.pdopt'.format(zuijia, file_path )
7.模型应用
导入需要应用模型进行预测的数据
对导入的数据按第5部分的预处理方法进行预处理
加载模型的最佳参数,对数据进行预测,评估预测结果
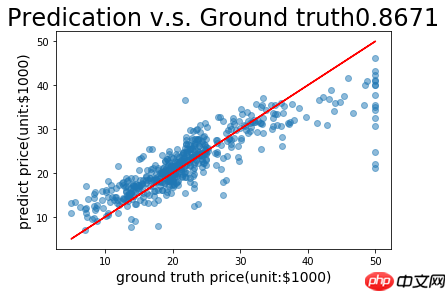
把预测值和实际值进行可视化处理
In [21]
# 从文件导入应用数据datafile = './yingyong.data'yingyong_data = np.fromfile(datafile, sep=' ') feature_names = ['CRIM', 'ZN', 'INDUS', 'CHAS', 'NOX', 'RM', 'AGE','DIS', 'RAD', 'TAX', 'PTRATIO', 'B', 'LSTAT', 'MEDV'] feature_num = len(feature_names)# 将原始数据进行Reshape,变成[N, 14]这样的形状yingyong_data = yingyong_data.reshape([yingyong_data.shape[0] // feature_num, feature_num])#!!归一化程序务必与第5部分所使用的完全一致!!只对属性进行归一化yingyong_features = feature_norm(yingyong_data[:, :13]) # print(feature_trian.shape)yingyong_data = np.c_[yingyong_features, yingyong_data[:, -1]].astype(np.float32)# print(training_data[0])登录后复制 In [22]
# load 最佳的参数batch_id=zuijia #zuijia1 !!!根据显示的epoch位置调整!!!layer_state_dict = paddle.load('best model2021-11-19 12:17:58/epoch270.pdparams')#layer_state_dict = paddle.load('checkpoint/epoch{}.pdparams'.format(batch_id))opt_state_dict = paddle.load('checkpoint/epoch{}.pdopt'.format(batch_id)) model.set_state_dict(layer_state_dict) optimizer.set_state_dict(opt_state_dict) # 获取预测数据INFER_BATCH_SIZE = len(yingyong_data) infer_features_np = np.array([data[:13] for data in yingyong_data]).astype("float32") infer_labels_np = np.array([data[-1] for data in yingyong_data]).astype("float32") infer_features = paddle.to_tensor(infer_features_np) infer_labels = paddle.to_tensor(infer_labels_np) fetch_list = model(infer_features) sum_cost = 0for i in range(INFER_BATCH_SIZE): infer_result = fetch_list[i][0] ground_truth = infer_labels[i] if i % 1 == 0: print("No.%d: infer result is %.2f,ground truth is %.2f" % (i, infer_result, ground_truth)) cost = paddle.pow(infer_result - ground_truth, 2) sum_cost += cost mean_loss = sum_cost / INFER_BATCH_SIZEprint("Mean loss is:", mean_loss.numpy())登录后复制 In [23]
x = pd.Series(flatten(fetch_list).tolist) y = pd.Series(infer_labels_np.tolist)计算相关系数:x与y间的相关系数为xxcorr,保留四位小数。
def plot_pred_ground(pred, ground): plt.figure() plt.title("Predication v.s. Ground truth"+ str(xycorr), fontsize=24) plt.xlabel("ground truth price(unit:$1000)", fontsize=14) plt.ylabel("predict price(unit:$1000)", fontsize=14) plt.scatter(ground, pred, alpha=0.5) # scatter:散点图,alpha:"透明度" plt.plot(ground, ground, c='red') plt.show() plot_pred_ground(fetch_list, infer_labels_np)登录后复制
8. 心得体会
利用这款研究工具,我对比了每次迭代前,先对训练数据进行随机打乱np.random.shuffle(train_data)与不进行该操作两种方法的效果,并深入理解了机器学习与传统模型之间的差异。
若不随机打乱训练数据顺序,传统的拟合过程表现为均方差loss持续下降,显示拟合效果不断优化。然而,将模型应用于测试集后却出现显著的loss变化,表明模型泛化能力不足,导致预测结果偏差大。
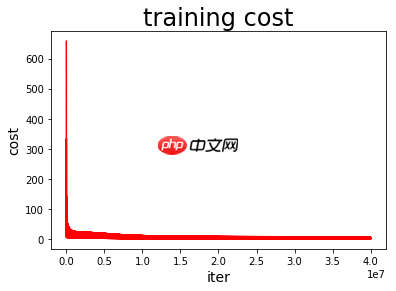
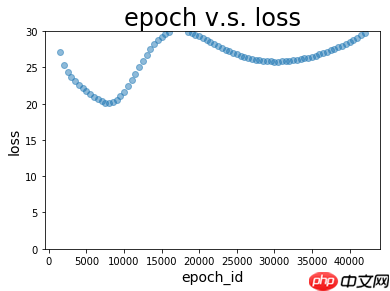
若对训练数据的顺序进行随机的打乱,程序执行的是机器学习过程,在此过程中均方差(MSE)损失值呈现波动下降趋势。每次打乱顺序后,loss都会出现短暂的脉冲变化,但经过模型优化处理,这些波动会逐渐平息并最终导致loss持续下降。当加载训练好的模型及参数对测试集进行预测时,观察到loss值非常低,并且在变化不大的区间内,这表明模型对新数据的泛化能力得到了显著提升,从而验证了优化后的模型性能的有效性。
以上就是基于PaddlePaddle2.2的数据建模研究助手的详细内容,更多请关注其它相关文章!
热门推荐
-
 基于PaddlePaddle2.0.0rc使用LSTM进行北京空气污染序列预测本项目使用PaddlePaddlec框架,在至间北京的空气污染数据基础上进行对比预测未来某时刻PM度
-
基于PaddlePaddle2.2的数据建模研究助手本项目基于PaddlePaddle在波士顿房价预测案例基础上进行优化改进。我们不仅关注了原始的epoch与loss对应图以及最低loss时的epoch-Id函数,
-
 基于网络创新形成的大数据的最突出特征是什么价值高,速度快。大数据指的是所涉及的资料量规模巨大到无法透过主流软件工具,在合理时间内达到撷取、管理、处理、并整理成为帮助企业经营决策更积极目的的资讯。
-
荣耀20pro怎么备份数据 荣耀20pro备份数据的方法首先打开桌面上的“设置”图标,然后点击最顶上的华为账号,||然后点击打开“云空间”,进入到云空间界面后,点击“云备份”,||打开“云备份”开关,这时候我们点击“立即备份”就可以马上进行备份数据了。
-
 永劫无间殷紫萍妲己捏脸数据-殷紫萍妲己捏脸二维码分享永劫无间殷紫萍妲己捏脸不知道有多少玩家尝试过,但是能捏成的没有几个,毕竟捏脸这是一个细致的活,很多玩家没有这个时间和技术,毕竟需要一定的美术功底,下面是小白为大家整理的永劫无间殷紫萍妲己捏脸数据二维码,一起来看看吧
-
 word里怎么选择一列数据 word里如何选择一列数据1、打开要复制的文档,按住键盘上的Alt键,再按住鼠标左键,框选需要的列,就可以选择需要的一列数据。2、用快捷键,按住CTrl+alt,然后用鼠标选择不需要保留的数据,选好以后松开快捷键,一键删除选中的数据,剩下的就是要
-
 帝国时代3怎么重置卡片(帝国时代3卡片数据修改)1、在《帝国时代3》里面找到要改的主城(记住名字)用记事本打开,根据自己要设定的国家,找到的文件名,比如设日本,那就选中homecityjapanese这个文件,复制,粘上到同一个目录中,再把这个粘的文件,改一个名字。
-
 手机克隆2021最新版-无需花钱就能轻松搞定数据迁移手机克隆221最新版供应了优良的资料迁徙服务,不妨免费帮助网友安好安稳的传输手机上重要的文件资料。大伙凡是都是在换新机的时刻使用这款手机克隆221最新版的,假如自
-
 Rhino 5.0钻石建模入门Rhinoceros多种领域中应用广泛,并且对电脑配置要求较低,比MAX更易于上手。今天我们将通过多边形放样和加盖工具,一步步制作出一个立体闪耀的钻石模型
-
 Arduino与Simulink建模指南搭建一个简易Simulink模型,实现对Arduino数字输出引脚状态的控制与切换。在MATLAB中,点击主页选项卡,选择新建,然后创建一个Simulink模型
-
 酷家乐怎么自己建模在装修设计领域,酷家乐是一款备受欢迎的软件。掌握在酷家乐中自己建模的技巧,能让你更自由地实现独特的设计构想
-
 手机3D建模软件推荐|免费下载支持安卓与iOS的实用建模工具大全随时随地进行手工创作、物品数字化归档或学习设计知识,不必局限于固定地点。通过使用手机端的免费三维建模与查看工具,你可以在日常生活中充分利用零碎时间,迅速完成建模扫
-
 精美建模游戏推荐 2025高人气精美建模手游TOP榜单随着游戏技术的进步,画面表现力显著增强。虚幻引擎成为高端游戏开发的主要工具,它们能够提供高度精细的建模和逼真的光影效果,使游戏角色更具层次感和立体感
-
摩尔庄园手游厨师怎么研究菜谱 厨师菜谱研究技巧摩尔庄园手游中,小伙伴们在成为厨师职业之后,就可以研究各种菜谱,烹饪各种美食料理,不过一些小伙伴还不清楚摩尔庄园手游厨师怎么研究菜谱,这里就来分享一下厨师菜谱研究
-
 Perplexity AI可以识别古树年轮吗 Perplexity AI气候历史研究PerplexityAI虽然不能直接用于古树年轮识别,但可以帮助研究人员查找与气候变化相关的研究成果和论文,发现开放的年轮数据库、气象记录或古气候重建项目,整合信
-
 全缝了!玩家研究《幻兽帕鲁》都借鉴了什么游戏据DualShockers报道,小伙伴们目下当今正纠结于《幻兽帕鲁》毕竟都“缝合”了市面上的那些游戏
-
 命运方舟达伦研究记录隐藏剧情在哪命运方舟是含有爽快的对打、影戏版剧情以及多用职业的一款MMORPG游戏。在游戏中有各色各样不同的任务,尚有很多的隐藏剧情,那么接下来就告诉网友命运方舟达伦研究记录隐藏剧情在哪。
-
 饿了么红包助手怎么关闭_饿了么红包助手关闭方法饿了么红包助手怎么关闭? 饿了么是一款网上订餐App,平台提供美食、鲜花、超市、甜品、生鲜、水果等商品订购,用户足不出户就可以轻松订餐。那么饿了么红包助手怎么关闭呢?以下是小编为大家整理的饿了么红包助手关闭方法,需要的小伙伴不要错过啊。
-
 拼多多红包助手怎么开启_拼多多红包助手开启方法拼多多红包助手怎么开启?拼多多是一款购物软件,软件提供了红包助手的功能,很多小伙伴想要进行使用,但是不知道具体位置在哪里。本期给大家带来拼多多红包助手开启方法,快来了解看看吧。
-
 拼多多红包助手在哪里开启_拼多多红包助手入口在哪里拼多多是一款购物软件,软件提供了红包助手的功能,很多小伙伴想要进行使用,但是还不知道拼多多红包助手在哪里开启的,下面就是相关的教程,希望能够帮助到大家。
-
 dnf助手角色动作设置方法_dnf助手怎么设置角色动作dnf助手是好多dnf网友都会用到的工具,在这款软件中,我们能够绑定自个的游戏账号,如许就能查看到账号干系新闻了。dnf助手何如设置角色举动?可能有的玩家还不太明晰。接下来小编就为网友带来了dnf助手设置角色举动的攻略讲解,期望对你有所帮助。
-
 欢视助手口令2025_欢视助手口令码大全最新可用欢视助手口令2025:欢视助手是一款功能丰富的电视直播应用。它汇集了众多电视台的直播频道,涵盖了新闻、综艺、体育和电影等多类节目。以下是小编为大家整理的欢视助手口令码大全,需要的小伙伴不要错过啊。