Flink高频面试题,附答案解析
时间:2026-09-16 15:32:06
进入主页,点击右上角“设为星标”,这样你就能比别人更快接收到优质文章。 Flink 的容错机制(checkpoint)
Flink 的 Checkpoint 是其可靠性的关键,确保在某个算子因异常退出等故障时,可以将整个应用流图的状态恢复到故障前的某一状态,保证流图状态的一致性。Flink 的 Checkpoint 机制基于“Chandy-Lamport algorithm”算法。
在应用启动时,Flink 的 JobManager 会为其创建一个 CheckpointCoordinator(检查点协调器),负责该应用的快照制作。
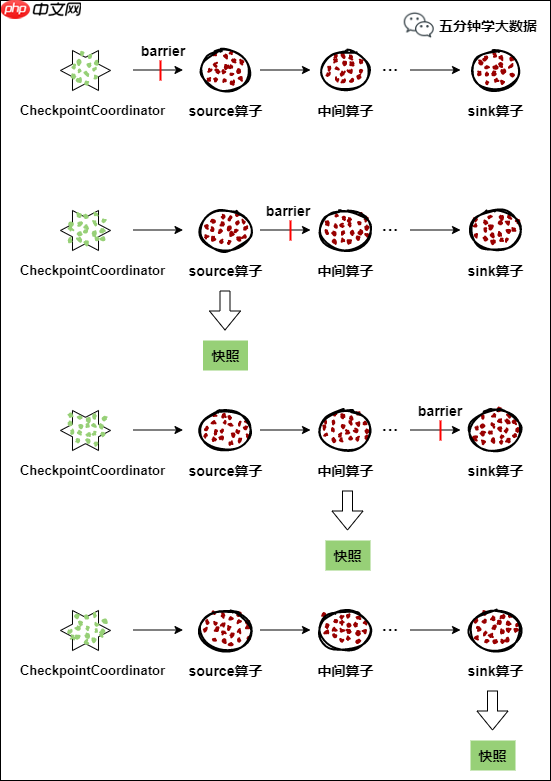
汇报和同步:CheckpointCoordinator 与源算子之间的协作CheckpointCoordinator 周期性地向流应用的所有源算子发送屏障(Barrier)。当某个源算子收到屏障时,会暂停数据处理过程,并将当前状态保存为快照,存入指定的持久化存储中。同时,它还会通知 CheckpointCoordinator 快照制作情况以及该屏障已成功广播给下游算子。下游算子接收到屏障后,也会暂停数据处理过程,并将自身状态保存为快照,再次存入指定的持久化存储,并向所有下游算子广播这个屏障,从而恢复数据处理。在整个过程中,每个算子按此步骤不断制作快照并广播屏障,直至屏障传递到流应用的最终sink算子。一旦 CheckpointCoordinator 收到了所有算子的报告,它认为该周期内快照制作成功;否则,在规定时间内没有收到所有算子的报告,则判断为本周期快照制作失败。 异步执行与状态同步为了确保数据处理过程中的信息传递和状态同步,CheckpointCoordinator 始终保持与下游算子之间的通信。这种方式不仅提高了异步处理的效率,还增强了系统的容错能力。同时,这种机制也允许上游算子在必要时暂停处理,以便资源能够集中到其他需要的地方。通过这样的设计,CheckpointCoordinator 能有效地控制和协调整个流应用的数据处理过程,确保数据一致性的同时,又能提供一定的灵活性和冗余性。
文章推荐:Flink 可靠性的基石 - checkpoint 机制详细解析 Flink Checkpoint 与 Spark 的相比,Flink 有什么区别或优势吗
在Flink中,时间(Time)可以分为几种类型: Event time:按事件发生的时间进行处理。当一个元素到达时才被计算。 Processing time:根据系统内部的时间节点来处理元素。例如,每隔计算一次聚合结果。这两种不同的时间处理方式在流处理中是完全独立的,并没有直接的关系。Flink 的时间处理机制为数据处理提供了灵活性和可扩展性,能够根据不同场景选择合适的处理方式。
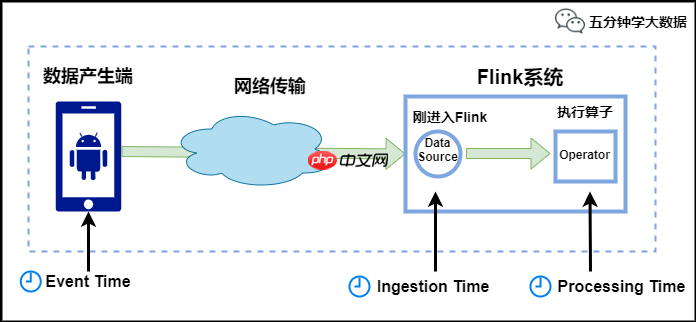
Flink 中的时间有三种类型,如下图所示:
Event Time: 事件创建时所处的时间点,通常通过事件中的时间戳(如采集的日志数据中每条日志都有自己的生成时间)来描述。Flink 使用时间戳分配器来确定事件的具体时间。Ingestion Time: 数据被 Flink 接收并处理的时刻。 Processing Time: 一个执行基于时间操作的算子在本地系统中的实际运行时间,与设备硬件相关,默认的时间属性就是 Processing Time。例如,一条日志进入 Flink 的时间为其到达时间。
- 01-22 10:00:00.123登录后复制,到达 Window 的系统时间为
- 01-22 10:00:01.234登录后复制,日志的内容如下:
- 01-06 18:37:15.624 INFO Fail over to rm2登录后复制。
在业务系统中,统计钟内故障日志的数量时,选择“eventTime”作为基准是最有意义的。这是因为我们是基于日志的生成时间来进行分析和统计数据的。对于迟缓的数据处理通常需要考虑如何确保其准确性、完整性和可靠性,从而避免对系统的性能造成负面影响或数据不一致的情况。
Flink 中 WaterMark 和 Window 机制解决了流式数据的乱序问题,对于因为延迟而顺序有误的数据,可以根据 eventTime 进行业务处理。对于延迟的数据,Flink 也有自己的解决办法,主要的办法是给定一个允许延迟的时间,在该时间范围内仍可以接受处理延迟数据: 设置允许延迟的时间是通过
allowedLateness(lateness: Time)登录后复制 设置。 保存延迟数据则是通过
sideOutputLateData(outputTag: OutputTag[T])登录后复制 保存。 获取延迟数据是通过
DataStream.getSideOutput(tag: OutputTag[X])登录后复制 获取。
文章推荐:Flink 中极其重要的 Time 与 Window 详细解析 Flink 的运行必须依赖 Hadoop 组件吗
在 Flink 中,一个集群包含以下几个关键角色:(Flink Manager(管理器),负责监控和配置整个系统的运行状态;(Task Scheduler(任务调度器),根据任务的优先级进行资源分配和任务调度;(Execution Environment(执行环境),提供数据流处理所需要的 API 和工具;(Data Collector(数据收集器),收集和传输 Flink 应用的数据到外部系统。例如,Flink 可以与 Yarn 集成,实现高效的资源调度;它可以读写 HDFS,支持大数据量的存储和分析;并且能够利用 HDFS 进行检查点管理,确保应用的高可用性。
Flink 集群的角色及任务# Master: Job Manager (也称为主机组) - 定义: 处理器,处理协调分布式执行,调度任务、检查点协调和失败后恢复等。 - 角色: - Leader: 一个主处理器,负责主要的协调工作。 - Standby: 其他备用处理器。# Worker: Task Manager (也称作从机) - 定义: 处理器,执行任务、数据缓冲和数据流交换,即处理数据flow中的task(或子task)。 - 角色: - 可能是多个,但至少一个工作处理器。# Client: 飞流客户端 - 定义: Flink程序的提交者,用户通过这个客户端将Flink程序传给集群处理。 - 作用: - 用户将Flink程序提交后,首先进行预处理,并将其发送到Flink群中处理。 - 然后从用户提交的Flink程序配置中获取JobManager的地址,并建立与JobManager的连接。# Flink资源管理:任务槽的概念 - 定义: Task Slot 是一种用于Flink集群资源管理概念,类似于传统的机器映射到Flink执行环境的方式。 - 作用: - 资源分配: - Task slot的数量决定了可以同时处理的任务数量限制。 - 可以通过调整slot的大小来改变资源使用的平衡。 - 状态管理: - 在任务运行期间,保持Task状态信息,以便在资源紧张时进行重新调度或失败恢复。 - 资源扩展: - 当系统资源增加时,可以动态增加槽位,提升性能。 - 当资源减少时,槽位数量可以自动缩减。总结:Flink 集群通过Job Manager、Task Manager和Client三个角色来协调分布式处理任务的调度、执行与数据流交换。而Task Slot则是用来管理集群资源的一种概念,它帮助在不同时刻平衡资源分配并支持系统的灵活扩展和性能优化。
在 Apache Flink 中,每个 TaskManager 是由 JVM 进程构成的,能够在多个线程中执行单个或多个子任务。为了管理一个工作进程接收的任务数量,它通过任务槽(Task Slots)进行控制(至少有一个)。Flink 支持多种重启策略来应对各种异常情况,比如失败、元数据丢失等。了解这些策略对于处理 Flink 应用程序的稳定性和性能至关重要。
Flink 支持不同的重启策略,这些重启策略控制着 job 失败后如何重启: 固定延迟重启策略:固定延迟重启策略会尝试一个给定的次数来重启 Job,如果超过了最大的重启次数,Job 最终将失败。在连续的两次重启尝试之间,重启策略会等待一个固定的时间。 失败率重启策略:失败率重启策略在 Job 失败后会重启,但是超过失败率后,Job 会最终被认定失败。在两个连续的重启尝试之间,重启策略会等待一个固定的时间。 无重启策略:Job 直接失败,不会尝试进行重启。 Flink 是如何保证 Exactly-once 语义的
Flink通过采用两阶段提交和状态保存机制确保端到端的一致性语义。以下是其工作步骤: 开始事务(beginTransaction):创建一个临时目录,用于存储写入的数据。 预提交(preCommit):将内存中的数据写入文件并关闭,确保数据的实时处理。 正式提交(commit):将之前写完的临时文件移动到目标目录中,代表最终数据的准确性。这会带来一定程度的数据延迟。 丢弃(abort):如果在上述过程中出现错误或决定不继续,可以丢弃所有已创建的临时文件。
如果在预提交成功后但未正式提交之前出现失败,可以考虑处理预提交数据以确保安全与一致性。
八张图理解 Flink 精准一次处理 Exactly-once- Flink 简化处理逻辑:减少冗余代码与错误。 - 模拟环境验证:确保语义正确性。 - 不依赖事务级存储,提升性能与稳定性。Flink 在无事务下精准处理保证,轻松实现Exactly-once。
端到端的 exactly-once 模式对目标系统有着很高的依赖性。为了满足这个需求,实现上通常有两种方式:幂等写入和事务性写入。在业务逻辑复杂的场景中,更常见的是采用事务性写入的方式。这种模式下,事务处理能够保证数据的一致性和完整性。然而,如果外部环境不支持事务,例如当某个系统不具备事务支持的能力时,可以使用预写日志(WAL)或两阶段提交(C)这两种方式之一。在 Flink 中,反压问题通常出现在数据流的处理过程中。为了应对这种情况,Flink 会采取一些机制来确保数据处理的一致性和可靠性。例如,它可能会采用多次读取和写入的方式,或者通过重试机制来解决数据丢失的问题。此外,Flink 还可以通过配置参数来调整吞吐量、延迟以及容错能力,从而在不同的场景下提供更加灵活的解决方案。
Flink 内部是基于 producer-consumer 模型来进行消息传递的,Flink 的反压设计也是基于这个模型。Flink 使用了高效有界的分布式阻塞队列,就像 Java 通用的阻塞队列(BlockingQueue)一样。下游消费者消费变慢,上游就会受到阻塞。 Flink 中的状态存储
在处理计算过程时,Flink 常常需要保存中间状态以防止数据丢失并确保状态恢复。选择的状态存储策略会影响持久化和检查点交互的方式。Flink 有三种状态存储方式:MemoryStateBackend、FsStateBackend 和 RocksDBStateBackend。为了支持流批一体的处理,Flink 提供了一种独特的机制来同时处理实时流计算(如 stream processing)和批处理作业(如 batch processing)。这个机制允许 Flink 在数据流的多个阶段上都使用相同的中间状态,从而在两者之间实现无缝对接。通过这种方式,Flink 能够有效地利用内存资源以提高性能,并确保在不同任务之间的持久化状态的一致性。总的来说,Flink 的这种设计使得它既能够处理实时数据流又能支持批处理作业,实现了真正的“流批一体”。
这道题问的比较开阔,如果知道 Flink 底层原理,可以详细说说,如果不是很了解,就直接简单一句话:Flink 的开发者认为批处理是流处理的一种特殊情况。批处理是有限的流处理。Flink 使用一个引擎支持了 DataSet API 和 DataStream API。 Flink 的内存管理是如何做的
Flink 不只是简单地将大量对象放在堆上,而是将这些对象通过序列化技术转换为内存块。此外,Flink 还广泛运用了堆外内存,这使得它的处理能力大大增强。在面对超出内存限制的情况时,Flink 会把部分数据存储到硬盘上以应对数据量的大幅增长。为了实现高效地操作二进制数据流,Flink 自己开发了一套序列化框架。在 Flink CEP 编程中,当状态尚未到达预期时,数据会被临时保存在哪里?
在流式处理中,CEP 的确需要支持 EventTime,并且应处理迟到数据,这种逻辑上的延后处理也是水印(watermark)的一部分。对于未匹配成功的事件序列以及迟到数据,Flink CEP 处理时,状态的更新和迟到数据都存储在同一结构中,即一个 Map 数据集。当设定事件序列的时间长度为 分钟时,这实际上也会消耗大量的内存资源。从这个角度讲,这也是一种对内存的巨大消耗。
文章推荐:详解 Flink CEP
--END--
以上就是Flink高频面试题,附答案解析的详细内容,更多请关注其它相关文章!
热门推荐
-
 Flink高频面试题,附答案解析进入主页,点击右上角“设为星标”,这样你就能比别人更快接收到优质文章。Flink的容错机制(checkpoint)Flink的Checkpoint是其可靠性的关键
-
 OPPO Find X8s屏幕有支持高频PWM调光吗,频率是多少在与手机屏幕相关的配置中,高频PWM调光非常重要,但不同品牌的手机在这方面可能存在差异。此次,OPPOFindX是否配备了这一功能?我们一起来了解一下
-
 华为Pura80 Pro+屏幕有支持高频PWM调光吗,频率是多少在手机屏幕上,有一种技术叫做高频PWM调光,它是用来提高屏幕的亮度和节能效果的,通常来说,这个参数越高越好,因为这意味着屏幕更节能且寿命更长
-
 三角洲行动香槟高频刷新点位在三角洲行动中,香槟是宝贵的红色战利品。为了找到它,我们需要关注以下频繁刷新的地点:蓝色区域:寻找蓝色指示标志时,记得观察周围的环境
-
 《汉字找茬王》公司面试找出公司10个坑人处通关攻略汉字找茬王游戏是一款乐趣闯关冒险类游戏,游戏的攻略分外的多样,网友在游戏中可能学到新的汉字和词语,提升自个的汉字程度,加强游戏的成就感,好多网友想知道汉字找茬王公
-
 腾讯游戏安全知识答题答案最新-2025腾讯游戏的安全知识答题腾讯游戏的安全知识答题你能全部答对吗,有时候系统根据用户的使用情况,如果有操作异常等现象,腾讯会相应的封号,用户只能进行答题解封,下面就是小编为大家整理的2022腾讯游戏的安全知识答题,一起来看看吧
-
 青年大学2022年第12期的答案截图 青年大学习2022年第12期答案汇总青年大学2022年第12期答案是什么?这是2022年第十二次青年大学习题目,下面小编为大家带来青年大学习2022年第12期答案最新,感兴趣的小伙伴一起了解一下吧。
-
 易拉罐装的带气饮料长时间存放在车里可能会爆炸还是挥发 蚂蚁庄园5.10答案最新易拉罐装的带气饮料长时间存放在车里可能会爆炸还是挥发?很多人习惯性把一些东西放在车里,其实有些东西会带来危害的,你知道吗,下面是小编为大家整理的蚂蚁庄园5.10答案,不知道你答对了吗
-
 蚂蚁庄园2022年5月8日答案汇总5月8日蚂蚁庄园的小问题分别是:我们常用“谁言寸草心,报得三春晖”歌颂母爱,它的作者是?“可怜天下父母心”这句名言是谁写的?相信很多小伙伴还不知道问题的答案,那么今天小编就为大家带来了这次的..
-
 明孝宗朱佑樘的年号是?-无悔华夏渔樵问答答案5.8明孝宗朱佑樘的年号你知道吗?无悔华夏近日开启的答题渔樵活动,玩家完成答题活动可以获取奖励,今天的问题和明朝有关系,你知道这个问题吗?一起来看看无悔华夏渔樵问答答案5.8吧,希望能帮到大伙
-
 笔记本充电指示灯一闪一闪怎么回事 笔记本充电指示灯一闪一闪原因解析1、电脑充电过程中因充电电源连接不当,接触不良而导致电源指示灯闪烁不停。需要重新确认电源连接线是否连接准确。2、电脑硬件运行错误也易导致指示灯的闪烁,可以关机重启。3、电池问题:在充电情况下,拔下电脑的电池,如果指示灯闪
-
 百变大侦探画舫遗恨凶手是谁 画舫遗恨凶手真相解析百变大侦探中最新的案件画舫遗恨,案件是爆发在中元时节,接下来小编为网友带来百变大侦探画舫遗恨凶手事实分析,好奇的玩家一块会意一下吧。
-
 三国群英传M豪杰要怎么玩 三国群英传M三种豪杰有点解析三国群英传M好汉要怎样玩?在游戏内,区别的职业攻略也大不相同,那么在游戏内好汉该若何玩呢?好奇的网友们一起来瞧瞧三国群英传M三种好汉有点分析吧,切切不要错过了。
-
 《原神》纳西妲配队解析 纳西妲队伍搭配推荐原神中纳西妲有着特有技能机制,在配队上也特别很是轻巧,想要明白她该怎么搭配队列的小伙伴请看接下来“Asgater”带来的原神纳西妲配队判辨,期望可以或许帮助大伙。
-
 辐射避难所人物属性解析辐射:避难所是一款生活策略类游戏,是辐射系列的作品之一。游戏中人物的属性共有7品种型,每一种属性都有着自个的用场。依据属性公道部署工作,能够让人物提高幸福感,让小伙伴的游戏过程变得加倍畅通。好多小伙伴会问游戏中人物的属性分别有甚么用?接下来就由小编给大伙逐一判辨吧。